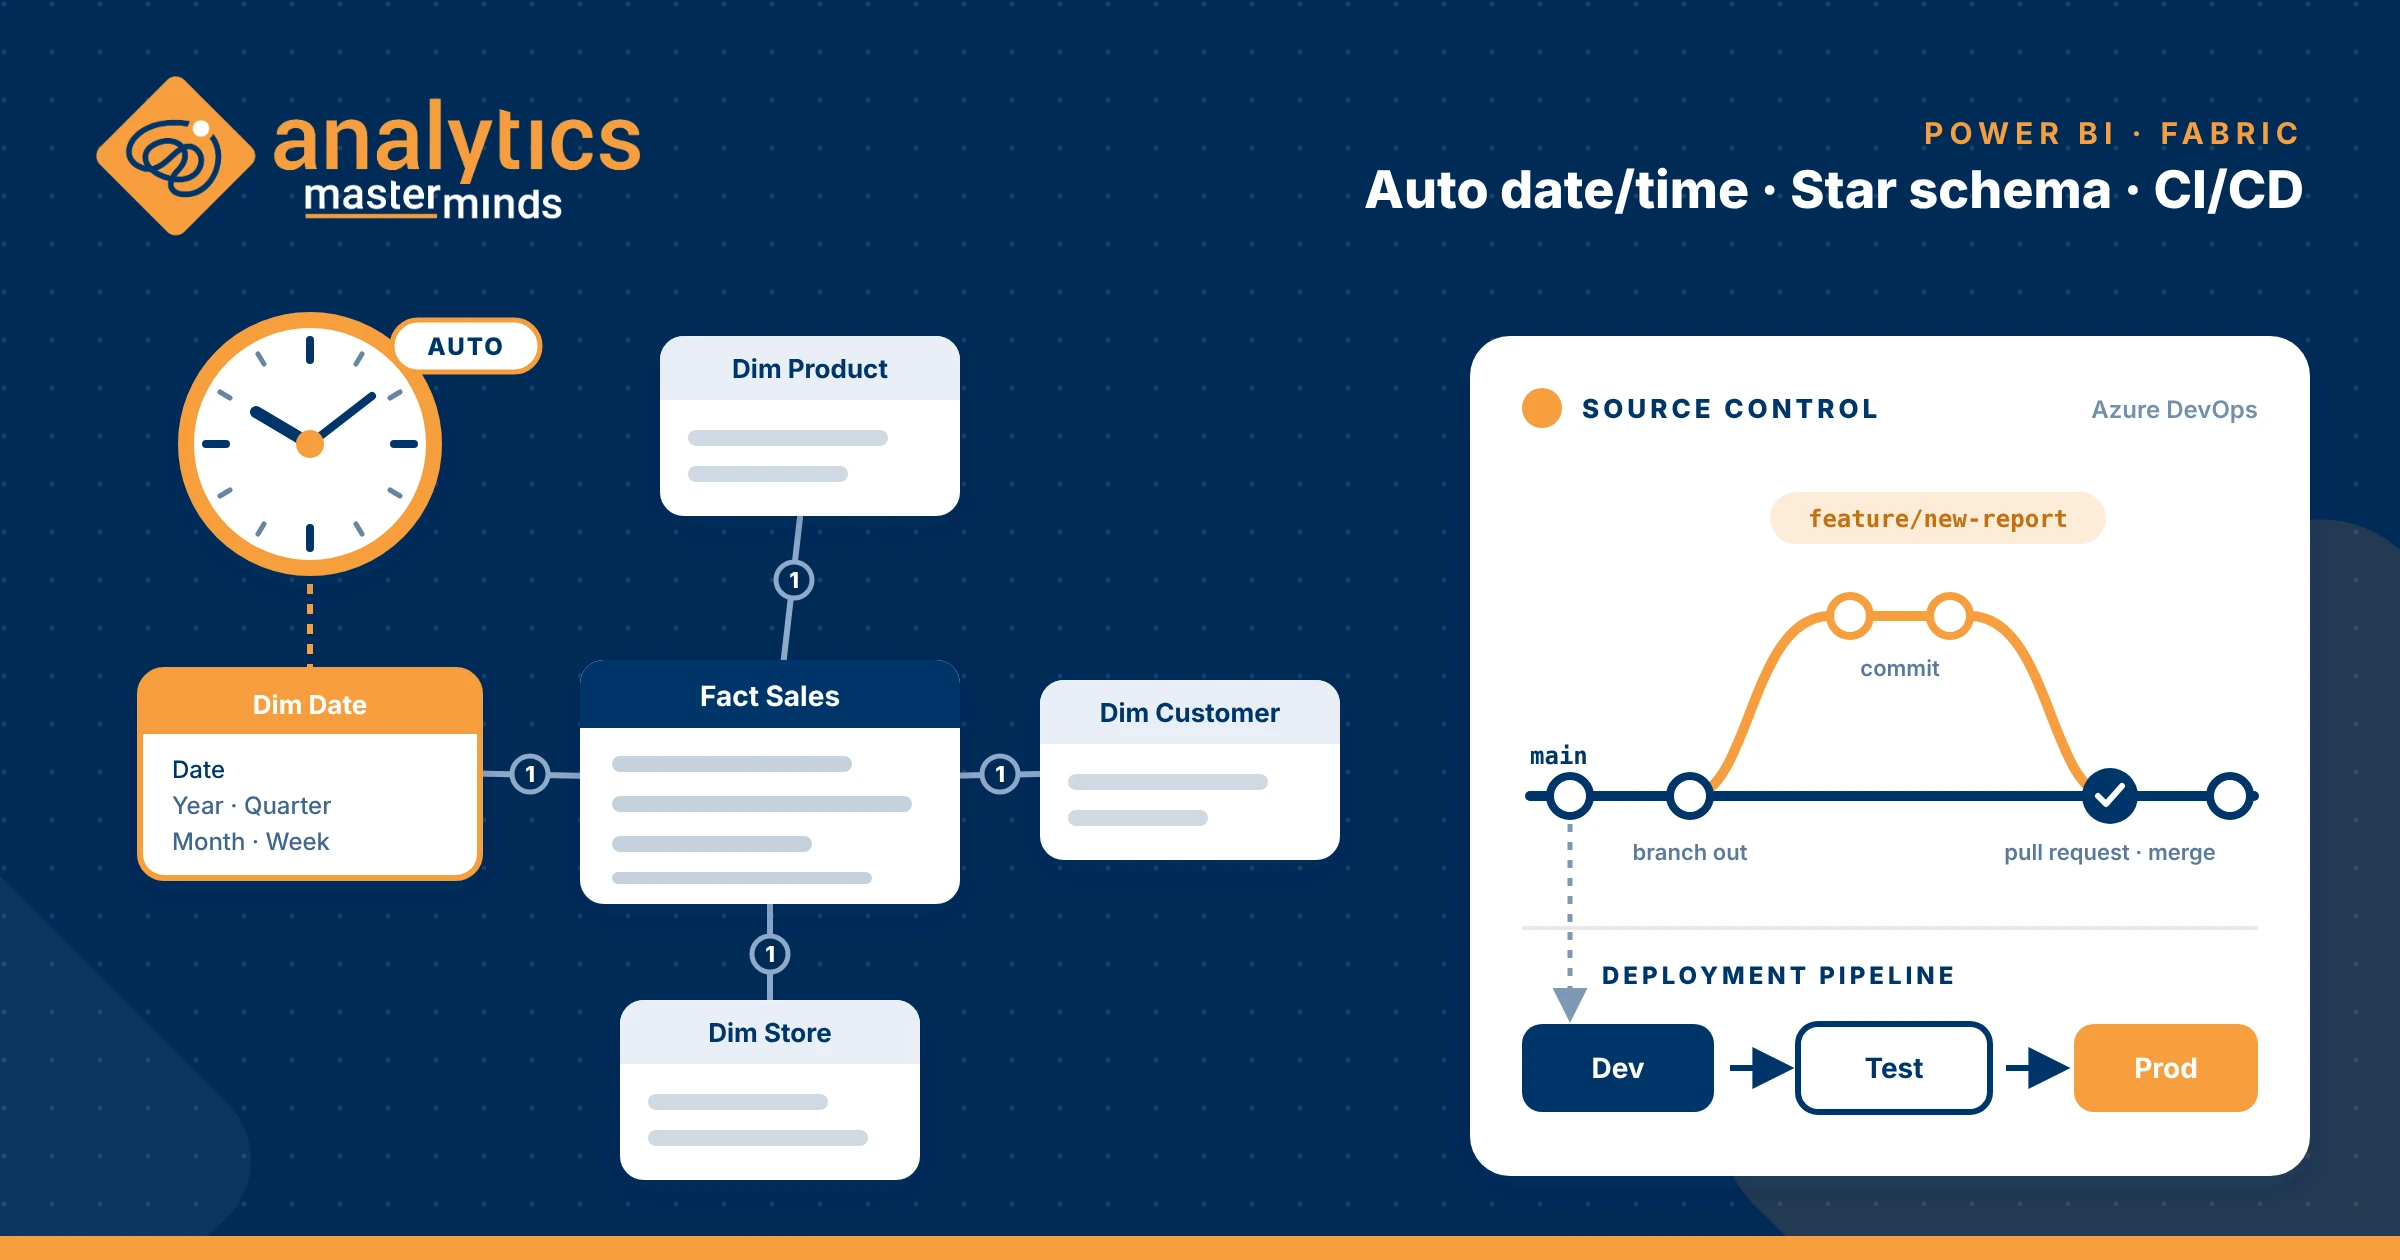
Sempre que entro no ambiente Power BI de um cliente, há três coisas que procuro quase de imediato.
- Desativaram o Auto date/time?
- Os modelos semânticos foram desenhados em torno de objetivos analíticos claros?
- Têm alguma forma de controlo de versões?
Porquê estas três? Porque me dão uma indicação precoce sobre três áreas diferentes de maturidade:
- Compreendem o Power BI enquanto ferramenta?
- Compreendem a modelação dimensional?
- Encaram o desenvolvimento em Power BI como desenvolvimento de software?
Claro que estas não são medidas definitivas da experiência de alguém. Há sempre exceções. Mas são indicadores surpreendentemente úteis de como um ambiente foi desenhado, desenvolvido e mantido. Vejamos porque é que são importantes. E se quiser que avaliemos o seu ambiente, descarregue o nosso formulário do Health Check para mais informações.
Tabelas Auto date/time ocultas
O Auto date/time é uma daquelas definições do Power BI Desktop que facilmente passam despercebidas. Quando está ativo, e está por predefinição, o Power BI cria automaticamente tabelas de datas ocultas para cada coluna de data elegível nos modelos Import. Cada tabela tem a sua própria coluna de data calculada e colunas adicionais para os atributos de data mais comuns. E normalmente não vê estas tabelas quando olha para o seu modelo.
Dependendo dos seus dados, pode acabar com várias tabelas adicionais sem se aperceber. Porque é que isto importa? Porque essas tabelas consomem memória, aumentam o tamanho do modelo e podem acrescentar tempo de processamento na atualização. E, talvez mais importante, não são necessariamente a melhor base para uma time intelligence consistente em toda a sua solução de análise.
Na maioria dos modelos de produção, recomendo criar antes uma dimensão de datas própria. Uma que controla e que pode reutilizar em todas as tabelas de factos. O Auto date/time não é errado em si, mas é uma definição que deve compreender e usar de forma deliberada.
Modelos semânticos monstruosos
Esta é provavelmente a área sobre a qual tenho opiniões mais fortes. E é algo que vejo com uma frequência surpreendente.
Um modelo semântico começa com relatórios de vendas. Depois alguém precisa de inventário. Depois de compras. Depois de finanças. E, em vez de pensar se estes requisitos pertencem ao mesmo sítio, acrescentam-se mais tabelas, relações e medidas. No fim, tem um modelo enorme que tenta responder a todas as perguntas que o negócio possa fazer.
Mas só porque consegue pôr tudo num único modelo semântico não significa que o deva fazer.
Ter várias tabelas de factos não é errado em si. Um modelo bem desenhado pode perfeitamente conter várias tabelas de factos, mesmo com granularidades diferentes. O que importa é que o modelo tenha um objetivo analítico claramente definido e que cada tabela de factos tenha uma granularidade consistente. Quando estes princípios são ignorados, as coisas tendem a complicar-se. As relações tornam-se mais difíceis de compreender. As medidas DAX ficam cada vez mais complexas. Os programadores criam soluções alternativas e os utilizadores começam a pôr os números em causa.
Um modelo grande não é necessariamente um mau modelo. Mas a complexidade deve ser intencional, e não o resultado de acrescentar cada vez mais sem repensar o desenho.
Se está perante um modelo monstruoso, comece por identificar as áreas analíticas que ele tem de suportar. Poderá encontrar oportunidades para separar responsabilidades, reutilizar dimensões e criar modelos mais fáceis de compreender e de manter.
O objetivo não é criar o maior número possível de modelos semânticos. É criar os modelos certos.
Desenvolvimento com controlo de versões
A terceira coisa que procuro é o controlo de versões. Quer tenha um programador ou uma equipa inteira. O que acontece se alguém introduzir uma alteração que estraga algo que funcionava ontem? Consegue identificar o que mudou? Consegue voltar atrás? E vários programadores conseguem colaborar sem pôr em risco o trabalho uns dos outros?
Se a sua estratégia de controlo de versões é uma pasta cheia de ficheiros PBIX com nomes como Final, Final_v2 e Final_ReallyFinal, talvez seja altura de repensar a abordagem.
Com os Power BI Projects (PBIP), definições de modelos e relatórios em texto e a integração com Git, temos possibilidades muito melhores para gerir o desenvolvimento em Power BI. Mas as ferramentas em si não são o mais importante.
O que conta é ter um processo deliberado para gerir alterações, proteger o que funciona e avançar com confiança. Desenvolvimento em Power BI é desenvolvimento de software. Merece a mesma atenção à qualidade e à facilidade de manutenção.
Três verificações. Três perspetivas.
Estas três verificações não me dizem tudo sobre a qualidade de um ambiente Power BI. Mas, em conjunto, são um ponto de partida útil.
Dizem-me algo sobre o quanto a organização compreende a ferramenta, os princípios da modelação dimensional e as práticas necessárias para manter soluções de análise ao longo do tempo.
E, no fim, as três afetam o negócio. Desempenho, fiabilidade, facilidade de manutenção e a confiança que os utilizadores têm nos seus relatórios.
Construir um relatório que funciona hoje é uma coisa. Construir uma solução de análise que continua a gerar valor à medida que o negócio evolui é algo completamente diferente.
Como se posiciona o seu ambiente Power BI?
Se não tem a certeza de como o seu ambiente está nestes fundamentos, ou se já enfrenta problemas de desempenho, modelos complicados ou dificuldades em gerir o desenvolvimento, teremos todo o gosto em ajudar.
O nosso Analytics Health Check oferece uma avaliação independente do seu ambiente de análise e ajuda a identificar riscos, oportunidades de melhoria e onde concentrar os seus esforços.
Porque saber o que melhorar é muitas vezes o primeiro passo para tirar mais valor daquilo que já construiu.
Tem curiosidade sobre o seu ambiente? Fale connosco ou comece com o nosso Analytics Health Check.