Zodra ik de Power BI-omgeving van een klant binnenstap, zijn er drie dingen waar ik vrijwel meteen naar kijk.
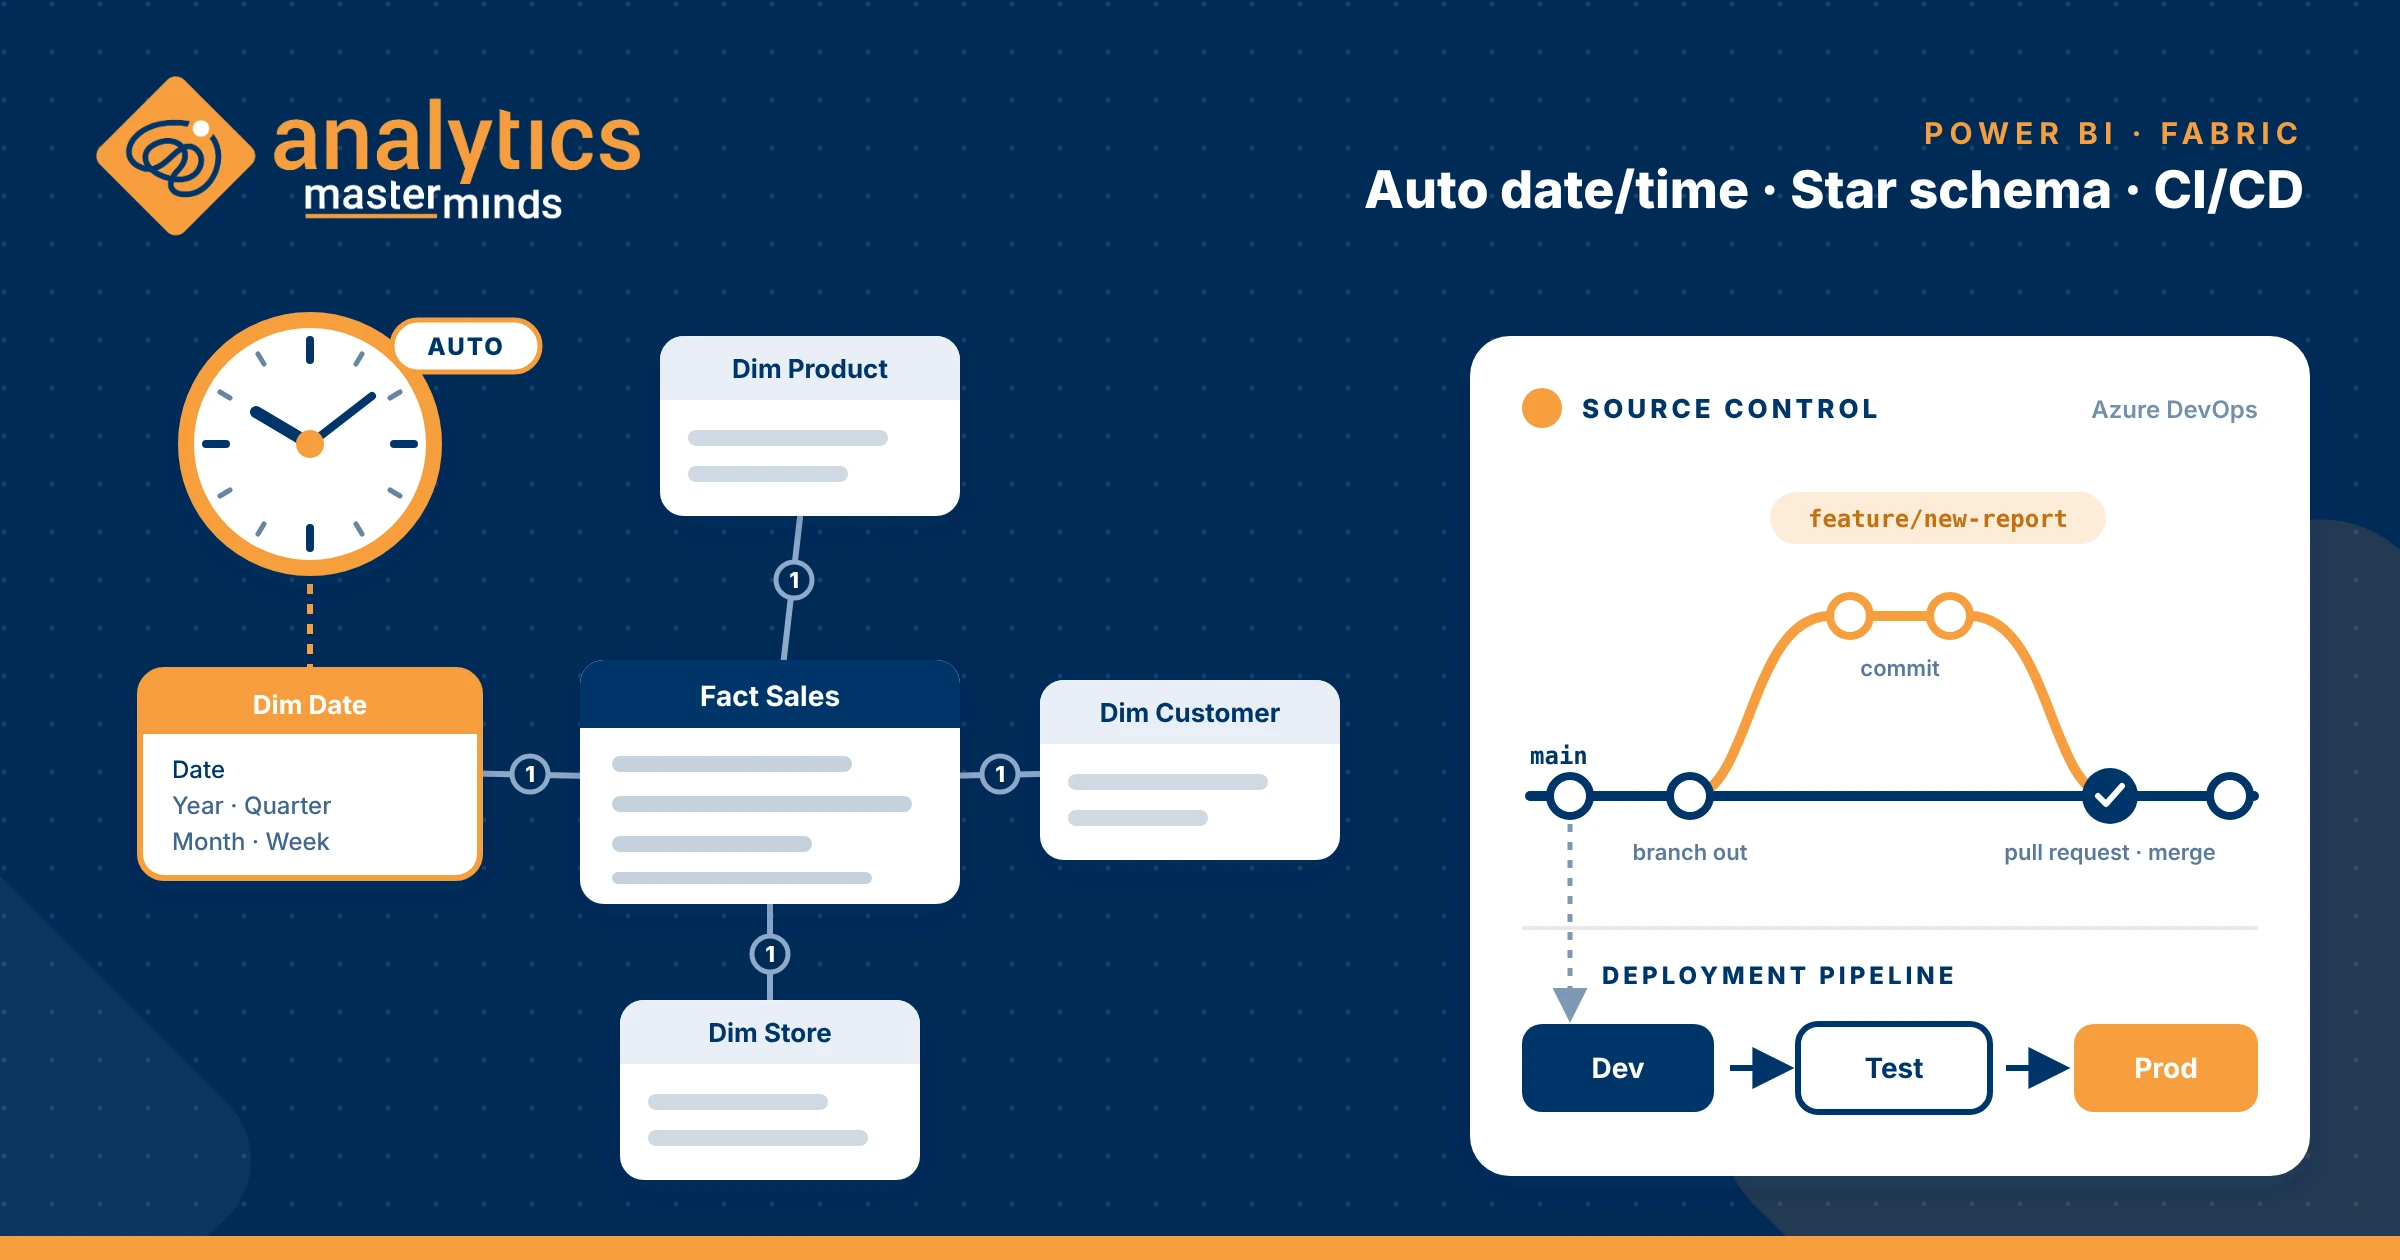
- Staat Auto date/time uit?
- Zijn de semantische modellen ontworpen rond een duidelijk analytisch doel?
- Is er enige vorm van versiebeheer?
Waarom juist deze drie? Omdat ze me al vroeg iets vertellen over drie verschillende vormen van volwassenheid:
- Begrijpt men Power BI als tool?
- Begrijpt men dimensioneel modelleren?
- Benadert men Power BI-ontwikkeling als softwareontwikkeling?
Natuurlijk zijn dit geen sluitende maatstaven voor iemands ervaring. Er zijn altijd uitzonderingen. Maar het zijn verrassend bruikbare aanwijzingen voor hoe een omgeving is ontworpen, ontwikkeld en onderhouden. Laten we kijken waarom ze ertoe doen. En wilt u dat wij uw omgeving beoordelen? Download dan ons Health Check-formulier voor meer informatie.
Verborgen Auto date/time-tabellen
Auto date/time is een van die instellingen in Power BI Desktop die makkelijk onopgemerkt blijven. Als de instelling aanstaat, en dat is standaard zo, maakt Power BI voor elke geschikte datumkolom in Import-modellen automatisch een verborgen datumtabel aan. Elke tabel krijgt een eigen berekende datumkolom en extra kolommen voor veelgebruikte datumkenmerken. En normaal gesproken ziet u deze tabellen niet als u naar uw model kijkt.
Afhankelijk van uw data kunt u zo met een flink aantal extra tabellen eindigen zonder het door te hebben. Waarom is dat belangrijk? Omdat die tabellen geheugen gebruiken, het model groter maken en extra verwerkingstijd kunnen kosten bij het verversen. En misschien nog belangrijker: ze zijn niet per se de beste basis voor consistente time intelligence in uw hele analytische oplossing.
Voor de meeste productiemodellen raad ik aan om in plaats daarvan een echte datumdimensie te maken. Eén die u zelf beheert en kunt hergebruiken voor al uw feitentabellen. Auto date/time is niet per definitie fout, maar het is een instelling die u moet begrijpen en bewust moet gebruiken.
Monsters van semantische modellen
Dit is waarschijnlijk het onderwerp waar ik het sterkst over denk. En het is iets wat ik verrassend vaak tegenkom.
Een semantisch model begint met verkooprapportage. Dan heeft iemand voorraad nodig. Dan inkoop. Dan financiën. En in plaats van te overwegen of die behoeften bij elkaar horen, worden er steeds meer tabellen, relaties en measures toegevoegd. Uiteindelijk heeft u een enorm model dat elke vraag probeert te beantwoorden die de organisatie maar kan stellen.
Maar dat u alles in één semantisch model kunt stoppen, betekent niet dat u dat ook moet doen.
Meerdere feitentabellen zijn op zich niet fout. Een goed ontworpen model kan prima meerdere feitentabellen bevatten, zelfs met een verschillende granulariteit. Waar het om gaat, is dat het model een duidelijk afgebakend analytisch doel heeft en dat elke feitentabel een consistente granulariteit heeft. Als die principes uit het oog verloren worden, wordt het al snel ingewikkeld. Relaties worden moeilijker te begrijpen. DAX-measures worden steeds complexer. Ontwikkelaars bouwen omwegen, en gebruikers gaan de cijfers in twijfel trekken.
Een groot model is niet per se een slecht model. Maar complexiteit moet een bewuste keuze zijn, niet het gevolg van steeds meer toevoegen zonder het ontwerp opnieuw te bekijken.
Heeft u te maken met een monstermodel? Begin dan met vast te stellen welke analytische gebieden het moet ondersteunen. Mogelijk vindt u kansen om verantwoordelijkheden te scheiden, dimensies te hergebruiken en modellen te maken die makkelijker te begrijpen en te onderhouden zijn.
Het doel is niet om zoveel mogelijk semantische modellen te maken. Het doel is om de juiste te maken.
Werken met versiebeheer
Het derde waar ik naar kijk, is versiebeheer. Of u nu één ontwikkelaar heeft of een heel team. Wat gebeurt er als iemand een wijziging doorvoert die iets kapotmaakt wat gisteren nog werkte? Kunt u achterhalen wat er is veranderd? Kunt u terug? En kunnen meerdere ontwikkelaars samenwerken zonder elkaars werk in gevaar te brengen?
Bestaat uw versiebeheer uit een map vol PBIX-bestanden met namen als Final, Final_v2 en Final_ReallyFinal? Dan is het misschien tijd om uw aanpak te heroverwegen.
Met Power BI Projects (PBIP), tekstgebaseerde model- en rapportdefinities en Git-integratie hebben we veel betere mogelijkheden om Power BI-ontwikkeling te beheren. Maar de tools zelf zijn niet het belangrijkste.
Het gaat om een bewust proces om wijzigingen te beheren, te beschermen wat werkt en met vertrouwen verder te gaan. Power BI-ontwikkeling is softwareontwikkeling. Het verdient dezelfde aandacht voor kwaliteit en onderhoudbaarheid.
Drie controles. Drie perspectieven.
Deze drie controles vertellen me niet alles over de kwaliteit van een Power BI-omgeving. Maar samen vormen ze een nuttig vertrekpunt.
Ze vertellen me iets over hoe goed de organisatie de tool begrijpt, de principes van dimensioneel modelleren en de werkwijzen die nodig zijn om analytische oplossingen op de lange termijn te onderhouden.
En uiteindelijk raken alle drie de organisatie. Prestaties, betrouwbaarheid, onderhoudbaarheid en het vertrouwen dat gebruikers in hun rapporten hebben.
Een rapport bouwen dat vandaag werkt, is één ding. Een analytische oplossing bouwen die waarde blijft leveren terwijl de organisatie verandert, is iets heel anders.
Hoe scoort uw Power BI-omgeving?
Weet u niet zeker hoe uw omgeving ervoor staat op deze basisprincipes, of heeft u nu al te maken met prestatieproblemen, ingewikkelde modellen of moeite met het beheren van ontwikkeling? Dan helpen we u graag.
Onze Analytics Health Check geeft een onafhankelijke beoordeling van uw analytische omgeving en helpt risico's, verbeterkansen en de juiste focus voor uw inspanningen in beeld te brengen.
Want weten wat u kunt verbeteren is vaak de eerste stap naar meer waarde uit wat u al heeft gebouwd.
Benieuwd naar uw omgeving? Neem contact op, of begin met onze Analytics Health Check.